用多个栈实现队列:题解
解法与贡献
采用出题人的贪心策略与栈底标记法。Codex(GPT-6)补充费用和交换论证、空操作串处理及标准 C++17 实现。栈和队列均为经典数据结构。
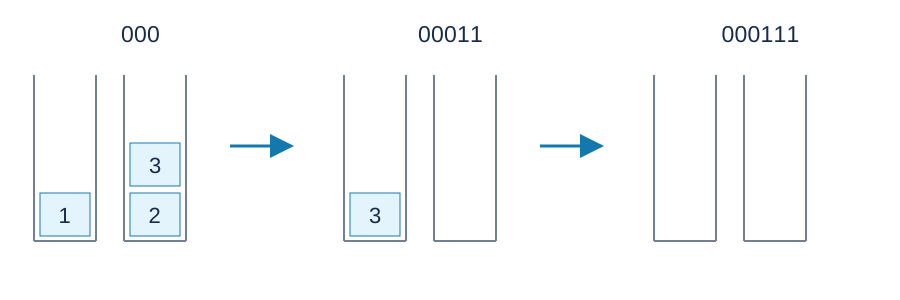
下图表示两个栈处理操作前缀 000 、00011 、000111 后的状态。数字为入队顺序编号,栈顶在上方;中间状态中元素三已经转移一次。
只保留会出队的元素
先模拟队列长度,数出有效出队次数 \(V\) .真正需要保存的恰好是最早的 \(V\) 个入队元素,按入队顺序编号为 \(1,\ldots,V\) .之后的输入元素可以直接不读入栈,也不会帮助之前的元素出队;保存它们只会占用空间并增加操作。
每个保留元素至少压入一次、输出时弹出一次,基础费用为 \(2V\) .每次转移再花二。因而只需最小化转移次数。
贪心的实际操作
入队时,有空栈就将新元素直接放在空栈底部。没有空栈,就放到紧前一个入队元素的上方。
出队时,若目标元素上方还有元素,逐个转移它们到另一个栈,优先选择非空栈;随后输出目标元素。转移使原来逆序的一段翻转成按出队顺序排列的一段,因此其中每个元素之后都能直接从栈顶输出。
这里有两个结构性质:未转移的连续入队段在栈中按入队顺序从底向顶排列;已转移段按出队顺序从顶向底排列。当需要翻转一段时,所有比它更早的元素已输出,其他非空栈底属于更晚的入队段,所以可以把这一段放到其上方。以后新元素有空栈时另开一栈,否则接在最新入队段后面,不会压住需要先输出的已转移段。
所以直接放在空栈底的元素不转移,费用为二;其他元素恰好转移一次,费用为四。
最优性:空栈与转移的交换
把一次转移的费用二作为一个单位。可将任意最优方案整理成上述形态而不增加单位数,依据以下交换规则。
有空栈时优先使用。 把新元素放在空栈底,不会挡住已有元素。若原方案稍后要使用这个空栈接收较早元素,把这些较早元素转移到新元素上方即可:它们都应先于新元素出队。于是原有转移不增加,新元素却不再必须为它下方的旧元素让路。
满栈时不提前搬旧元素腾位。 新元素若直接压入非空栈,必在其下方旧元素出队前被转移,至少花一个单位。若先腾出空栈,则至少有一次转移将某个原有栈的最后一个旧元素搬走,同样已花一个单位。可把这个单位改记为新元素以后的一次转移:让旧元素留在原栈,新元素接在最新入队段上。旧元素比新元素早出队,它原来的栈最晚在这时释放,可以接收之后需要翻转的段;若期间又有新输入,则一起接在该段后面。此交换不会推迟一个较早元素可用的空栈,也不增加转移的总配额。逐次消去只为新输入腾位的提前转移即可。
溢出元素接在最新入队段上。 若把新元素压在更早的段上,它只会更早挡住出队。将它及其后续连续输入移到最新段顶,所有早于该段的输出都不受阻;当该段需输出时,一次翻转按所需顺序取出这些元素。若原方案分散存放这些新元素,它们各自也至少转移一次。集中存放没有额外转移,并使较早段的栈尽早释放。
这些交换按操作时间依次应用,保留此前已经确定的输出,得到“能用空栈就用、否则接最新段、仅在出队需要时翻转”的方案。翻转优先使用非空栈,是因为较早元素可以安全放到较晚元素上方;占用额外空栈不会减少本次搬运次数,却可能使后来的输入无空栈可用。因此它也不劣。
贪心恰好给每个需要转移的元素支付一个单位,故在所有合法方案中总费用最小。这里的下界不是“每次当场满栈都永远必须搬新元素”:提前搬旧元素也能腾位,但交换论证说明这样并不能降低总费用。
只维护栈底
不必保存实际栈内容。维护空栈数 \(E\) 、已保留入队数 \(P\) 、已出队数 \(Q\) ,以及 Bottom[x] ,表示元素 \(x\) 目前是否位于栈底。
- 入队且 \(P<V\) :若 \(E>0\) ,令 \(E\) 减一,将新元素标为栈底并给答案加二;否则加四。
- 有效出队:令 \(Q\) 加一,若它是栈底,就给 \(E\) 加一。
- 每步结束后,如果 \(P>Q\) 而 \(E=n\) ,说明刚才翻转的一段实际上占用了一个空栈。将 \(E\) 改为 \(n-1\) ,并把最后入队元素 \(P\) 标为栈底。它已经付过转移费用,不能再给答案加二。
最后一种情况是仅用栈底标记时必须补回的占用。翻转后最后入队元素位于这一段的最下方。
复杂度与实现
两次扫描,总时间 \(O(m)\) ,空间 \(O(m)\) ,数组只按操作数分配,不能按可能达到十亿的栈数分配。\(V\le\lfloor m/2\rfloor\) ,答案至多 \(4V\le2m\) ,三十二位有符号整数足够。\(m=0\) 时无需读取字符串,答案为零。参考程序。
显式维护栈和逐次转移可构造同样费用的合法执行过程,但计算答案只需要栈底标记。小规模还可以枚举所有栈状态并按时间段做最短路,作为独立核验;其状态数量不适用于本题范围。