DNA 双链序列计数
预估时间限制:0.5 秒。内存限制:128 MB。
实际时限以标准程序在目标评测环境的最慢用例中位时间乘以 \(2\) ,按 \(0.5\) 秒向上取整。参考环境见评测说明。
背景故事
在本题的双链无环 DNA 模型中,两条链互补且反向排列。给定碱基对数,统计不同分子的种类。下面用字符串定义何时两种表示属于同一个分子。
形式化问题描述
字母表为 A 、T 、C 、G ,互补配对为 A 与 T 、C 与 G .每个字母恰有一个互补字母。
一个含 \(n\) 个碱基对的双链分子可用长度为 \(n\) 的字符串 \(s=s_1\cdots s_n\) 表示。定义它的反向互补串
\[
R(s)=\overline{s_n}\,\overline{s_{n-1}}\cdots\overline{s_1}
\]
横线表示取互补字母。两个字符串表示相同分子,当且仅当它们相等,或者其中一个等于另一个的反向互补串。
每次询问给出 \(n\) ,求不同分子数对 \(10^9+7\) 取模后的值。共有 \(m\) 次询问,最终只输出所有这些余数的按位异或结果。
输入格式
第一行整数 \(m\) .接下来 \(m\) 行,每行一个整数 \(n\) ,表示一次询问的长度。
输出格式
输出一行一个非负整数,表示各询问的计数先对 \(10^9+7\) 取模,再按位异或的结果。
样例
样例 1
输入
3
1
2
3
输出
40
样例 2
输入
4
1
1
2
2
输出
0
样例 3
输入
1
4
输出
136
样例解释
长度为一、二、三时,分子数分别为 \(2,10,32\) ,所以第一组输出 \(2\mathbin{\oplus}10\mathbin{\oplus}32=40\) .第二组每种长度都出现两次,异或结果为零。长度为四时有 \(136\) 种,得到第三组输出。
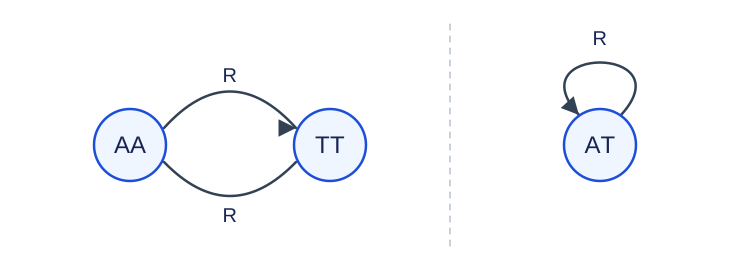
箭头表示反向互补。AA 和 TT 属于同一类;AT 的反向互补仍是 AT .图中两种情况都各计一个分子。
数据范围与保证
对所有数据,\(1\le m\le500000\) ,\(1\le n\le10^9\) .询问可重复。
| 分值比例 | 额外条件 |
|---|---|
| 100% | 无额外条件 |