编辑城镇与模拟币2:题解
算法与贡献
Codex(GPT-6)给出相邻平均势函数的最优性证明、按家庭批量计算的系数公式、实现与验证。标准程序使用逆序系数尾和;前向批量平均及其程序维护各目标成员的财富,以更高时间开销换取较少的预处理空间。
个人财富与目标
记 \(k=p_1\)、\(a=m_1/k\) .拆开初始家庭后,每人持有该家庭的人均财富;合并若干人再拆开,相当于将这些人的财富全部替换为均值。搬走一人不改变源家庭其他人的人均财富,因此任意编辑都可以在这个个人财富模型下分析。
最终将全部目标成员合为一家,总财富就是这 \(k\) 个人财富之和。过程中可以使用任意多个临时家庭。
任意编辑都不能超过的上界
这一段允许目标成员的当前财富不同,以便把同一结论用于任何中间状态。
将所有人按财富非降排序,目标标为 \(T\) ,外部标为 \(O\) .只要相邻标签为 \(TO\) ,就将两人的财富平均,并交换他们在排序表中的位置。两人现在同样富,列表仍然有序。重复直到全部 \(O\) 位于全部 \(T\) 之前,将此时的目标财富总和记为 \(\Phi\) .
操作顺序不影响结果。 每步消除一个标签逆序。两个同时可操作的 \(TO\) 不可能重叠,它们作用于不同坐标,可以交换执行顺序。对逆序数归纳,所有执行顺序得到同一个最终财富向量。
每一步都不减少目标财富。 被平均的目标成员不比外部成员富。因此 \(\Phi\) 不小于当前目标财富总和,而且这个值可用有限步达到。
任意两人平均都不增加 \(\Phi\) . 固定财富排序后,所有操作都是固定的相邻平均矩阵,\(\Phi\) 是初始财富的线性函数。结束时目标总和对有序坐标的系数是
倒推操作时,每步同样把相邻两个系数平均,所以系数始终非降。也就是说,较富坐标的系数不小于较穷坐标。
让任意两人的财富 \(x<y\) 连续向均值靠近。在排序固定的一段中,设对应系数为 \(c_x\le c_y\) ,向较穷者转移 \(\delta\) 会使势函数变化
排序发生变化时,\(\Phi\) 连续:两个同类人员在相等财富处交换没有影响;异类人员在相等处可以先执行那次不改变财富的 \(TO\) 操作,得到另一侧的问题。整个平均过程经过有限个排序区间,因此 \(\Phi\) 不增。
多人平均也不增加 \(\Phi\) . 一组人的完全平均可由该组内反复的两人平均逼近,连续性将不增结论推广到这个极限。这仅用于证明上界;达到上界的策略本身只有有限步。
于是任意编辑后的目标财富不超过当时的 \(\Phi\) ,后者又不超过初始 \(\Phi\) .前述相邻策略恰好达到它,最优性得证。相关的离散平均模型见 Hay、Schiff、Fisch 的研究;这里给出了本题所用势函数的完整证明,不需要枚举一般模型的极点。
将最优策略写成网格
初始所有目标成员都拥有 \(a\) .不比 \(a\) 富的外部居民已经排在目标之前,不参与操作。将其余 \(r\) 位居民的财富排为 \(v_1\le\cdots\le v_r\) .
按这个顺序处理外部居民。每人依次与目标中较富者到较穷者平均,刚处理完的外部居民不再使用。以 \(x_{i,j}\) 表示第 \(j\) 人与第 \(i\) 位目标成员平均后的共同财富,则
答案为 \(\sum_{i=1}^{k}x_{i,r}\) .这个递推适合小规模检验,但总人口可接近 \(10^{12}\) ,不能直接展开。
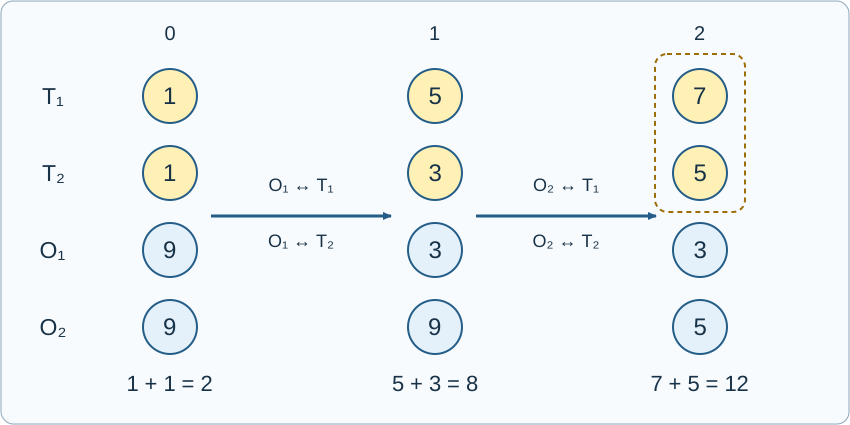
计算一个外部居民的贡献
从所有财富中减去 \(a\) ,目标初值变为0。若某位外部居民之后还有 \(t\) 人,它的增量 \(v-a\) 对最终目标总财富的系数是
这是网格上的路径计数:从该列上边界进入第 \(i\) 行、再到最后一列,需要 \(i+t\) 次取半,共有 \(\binom{t+i-1}{i-1}\) 条路径。
定义系数尾和 \(T(r)=\sum_{t=r}^{\infty}c_t\) .交换求和次序后,有
下面说明这个尾和恒等式。固定 \(i\) ,\(\binom{t+i-1}{i-1}/2^{t+i}\) 是抛公平硬币时,第 \(i\) 次正面前恰有 \(t\) 次反面的概率。至少有 \(r\) 次反面,等价于第 \(r\) 次反面之前正面数 \(j<i\) .因此其尾和为 \(\sum_{j=0}^{i-1}\binom{r+j-1}{j}/2^{r+j}\) .再对 \(i=1,\ldots,k\) 求和,同一个 \(j\) 出现 \(k-j\) 次,得到上式。
一次处理整个家庭
从初始人均财富高的家庭向低的家庭扫描,只处理人均财富大于 \(a\) 的家庭。设已经扫描了 \(r\) 位居民,当前家庭有 \(p\) 人、人均财富为 \(v\) ,则它对目标总财富的贡献为
从 \(m_1\) 开始累加这些贡献即可。相同均值的家庭可任意排序,因为相邻系数差会相消。
每个 \(T(r)\) 的有限和只需 \(O(k)\) 次运算。递推二项式:
预处理 \(1,\ldots,M\) 的模逆及 \(2^{-p}\) ,其中 \(M=\max_i p_i\) .扫描时把当前 \(2^{-r}\) 乘以 \(2^{-p}\) 即可更新。初始均值比较用整数交叉乘法,不能比较模值。
总人数 \(r\) 可以超过 \(P\) .上面的递推仍然成立,因为它只除以 \(1,\ldots,k-1\) ,都是可逆的;不能改成需要对 \(r!\) 求逆的实现。每个最优财富的分母只涉及初始人数和2的幂,均与 \(P\) 互素。人数总和及均值交叉乘积使用64位整数,模乘积也在有符号64位范围内。
复杂度、方案选择与检验
时间 \(O(n\log n+nk+M)\) ,空间 \(O(n+M+k)\) .标准程序保存逆元和负幂表,以较低的每家庭计算量处理全部数据。
前向方案直接维护 \(k\) 位目标成员的财富,通过下三角矩阵的有限二项式展开批量处理家庭。它的空间为 \(O(n+k)\) ,但每个家庭需要 \(O(k^2+\log P+\log M)\) 时间。两种方案的完整测量和通过情况见性能记录,在其他平台须重新校准。
小输入使用精确 Fraction 网格;大规模等均值分组使用从逐人操作直接构造的矩阵和通用快速幂。两份一般大规模输入以逆序尾和与前向卷积交叉验证,并依赖上述证明,不称为独立穷举。另检查任意子集平均不会提高势函数、人口跨越模数,以及非法输入与输出。复现说明。